
Giải thích
Cấu Hình Timeout, Retry Và Polling Modbus Sai Gây Treo Hệ Thống Hoặc Quá Tải Gateway
Một hệ thống Modbus RTU/TCP thường được cấu hình timeout, retry count và polling rate ngay từ đầu dựa trên vài thiết bị thử nghiệm, rồi mở rộng dần theo thời gian mà không xem lại ba thông số này. Vấn đề là ba thông số này không độc lập với nhau — chúng cộng dồn thành tổng thời gian một vòng polling cần để quét hết toàn bộ thiết bị, và khi số lượng thiết bị tăng, tổng thời gian này có thể vượt xa mức chấp nhận được dù từng thông số riêng lẻ “trông vẫn hợp lý”.
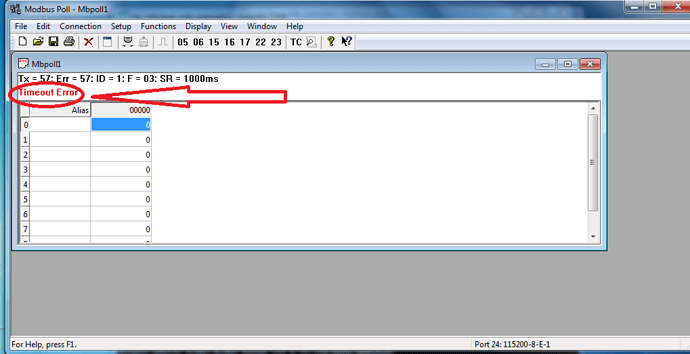
Mối quan hệ giữa polling rate, timeout và retry count
Trong một chu kỳ polling Modbus (master hỏi tuần tự từng slave), thời gian cho mỗi request gồm: thời gian slave phản hồi bình thường (thường vài chục ms), cộng với timeout chờ nếu không có phản hồi, nhân với số lần retry nếu request đầu thất bại. Nếu một slave trong chuỗi bị lỗi hoặc mất kết nối, master phải chờ đủ timeout × (1 + số lần retry) trước khi bỏ qua và chuyển sang slave tiếp theo — với timeout 3 giây và retry 3 lần, một slave lỗi có thể chiếm tới 12 giây của master trước khi vòng polling tiếp tục, làm chậm toàn bộ chuỗi thiết bị phía sau nó trong cùng vòng quét tuần tự.
Đặt timeout quá ngắn (dưới thời gian phản hồi thực tế của thiết bị trong điều kiện tải cao) khiến master coi các phản hồi hợp lệ nhưng đến hơi muộn là timeout giả — dẫn đến retry không cần thiết, tăng lưu lượng trên bus/mạng, và trong một số trường hợp còn khiến slave nhận request trùng lặp gây nhầm lẫn trạng thái nếu request đó là lệnh ghi thay vì đọc. Ngược lại, đặt timeout hoặc retry quá nhiều để “chắc chắn không bỏ sót dữ liệu” khiến một thiết bị lỗi thực sự có thể chiếm dụng phần lớn thời gian của cả vòng polling, làm toàn bộ các thiết bị khác trong cùng vòng quét bị delay dây chuyền — đây chính là cơ chế khiến hệ thống “treo” khi một thiết bị hỏng: không phải Gateway bị lỗi, mà nó đang chờ đúng theo cấu hình timeout/retry đã đặt cho thiết bị lỗi đó.
Polling quá nhanh có làm treo slave không?
Nhiều thiết bị slave (đặc biệt cảm biến/PLC giá rẻ) xử lý request Modbus bằng vòng lặp chính chia sẻ tài nguyên với các tác vụ khác của thiết bị — nếu polling rate quá nhanh so với khả năng xử lý của slave, hàng đợi request có thể tràn hoặc slave phản hồi chậm dần, tạo cảm giác “càng hỏi nhanh, phản hồi càng chậm”. Đây không phải lỗi thiết kế của slave mà là giới hạn tài nguyên xử lý thực tế của một thiết bị nhúng nhỏ. Polling rate hợp lý nên dựa theo tài liệu kỹ thuật của slave nếu có công bố tần suất tối đa, hoặc thử nghiệm tăng dần cho tới khi thấy dấu hiệu chậm lại.
Gateway xử lý được bao nhiêu request đồng thời trước khi drop?
Một Gateway Modbus làm cầu nối Modbus TCP – Modbus RTU phải xử lý nhiều request TCP đến gần như đồng thời từ phía trên (SCADA, nhiều client) nhưng chỉ có thể gửi tuần tự từng request xuống bus RTU phía dưới (vì RTU là bus chia sẻ, không hỗ trợ nhiều request cùng lúc). Khi số request TCP đến vượt quá khả năng xử lý tuần tự này, Gateway phải xếp hàng đợi — nếu hàng đợi đầy, các request mới có thể bị drop hoặc client nhận timeout dù bản thân bus RTU phía dưới vẫn hoạt động bình thường. Giới hạn cụ thể (số request đồng thời tối đa, kích thước hàng đợi) khác nhau theo từng model Gateway và nên tham khảo thông số kỹ thuật của nhà sản xuất để có con số chính xác cho từng dòng thiết bị, thay vì giả định chung.
Cách ước lượng cấu hình hợp lý
- Đặt timeout dựa trên thời gian phản hồi thực tế đo được của slave chậm nhất cộng thêm biên an toàn, không đặt tùy tiện theo cảm tính.
- Giới hạn retry ở mức thấp (1-2 lần) cho ứng dụng cần phản hồi nhanh, chấp nhận bỏ qua request lỗi và thử lại ở vòng polling kế tiếp thay vì cố retry ngay.
- Tính tổng thời gian vòng polling xấu nhất (khi có N slave lỗi cùng lúc) để đảm bảo vẫn nằm trong ngưỡng chấp nhận được của ứng dụng giám sát.
- Khi số lượng thiết bị tăng đáng kể, nên chia nhỏ thành nhiều nhóm polling song song (nếu Gateway hỗ trợ đa cổng hoặc đa luồng) thay vì dồn hết vào một chuỗi tuần tự.
Gateway PROTO hỗ trợ cấu hình timeout/retry riêng theo từng thiết bị (thay vì một giá trị chung cho toàn bus) và cơ chế polling đa luồng trên các cổng độc lập, giúp một thiết bị lỗi không kéo chậm toàn bộ hệ thống — nhưng việc tính toán cấu hình hợp lý ban đầu vẫn cần dựa trên đặc tính thực tế của từng slave trong hệ thống.


